A los equipos de investigación médica no les faltan datos. Les faltan datos conectados. La imagen está en el PACS. El cuadro clínico está en la historia clínica, la mitad encerrado en informes de alta de texto libre. La genómica es un VCF en una carpeta compartida del laboratorio. Las cifras de supervivencia salen de un paquete estadístico que no habla con nada de lo anterior. La literatura que lo pone todo en contexto vive en cien pestañas del navegador.
Roberto Cruz
10 de julio de 2026
Publicado originalmente en LinkedIn
Cada uno de esos sistemas hace su trabajo. El problema es el espacio entre ellos. Una pregunta de investigación que debería llevar una tarde lleva un trimestre, porque la mayor parte del trimestre se va en mover datos a mano entre huecos: exportar, volver a identificar quién es quién, pegar una definición de cohorte en tres herramientas que definen la cohorte de forma distinta, recalcular una cifra que alguien ya calculó el mes pasado y (en silencio, a un alto coste) perder el hilo de dónde salió realmente cada resultado.
Lo que acelera a un equipo de investigación no es un modelo más rápido. Es cerrar los huecos. Un lugar donde la imagen, la historia, las variantes, la estadística y la evidencia estén en el mismo lienzo, donde un resultado lleve su propia historia, y donde la maquinaria del estudio (desidentificación, lógica de cohortes, anotación, firma) forme parte de la superficie en lugar de ser un montón de tareas paralelas. Para eso construimos el entorno de investigación de Tietai, y la forma más rápida de mostrar lo que cambia es seguir un único estudio desde los datos brutos hasta un hallazgo que podrías defender ante un comité de revisión.
Un hilo: una cohorte de cáncer de páncreas
Tomemos una pregunta con forma real. ¿Cambia la terapia neoadyuvante la supervivencia en el adenocarcinoma ductal de páncreas resecable, y podemos ver la señal en nuestros propios pacientes antes de diseñar un ensayo en torno a ella?
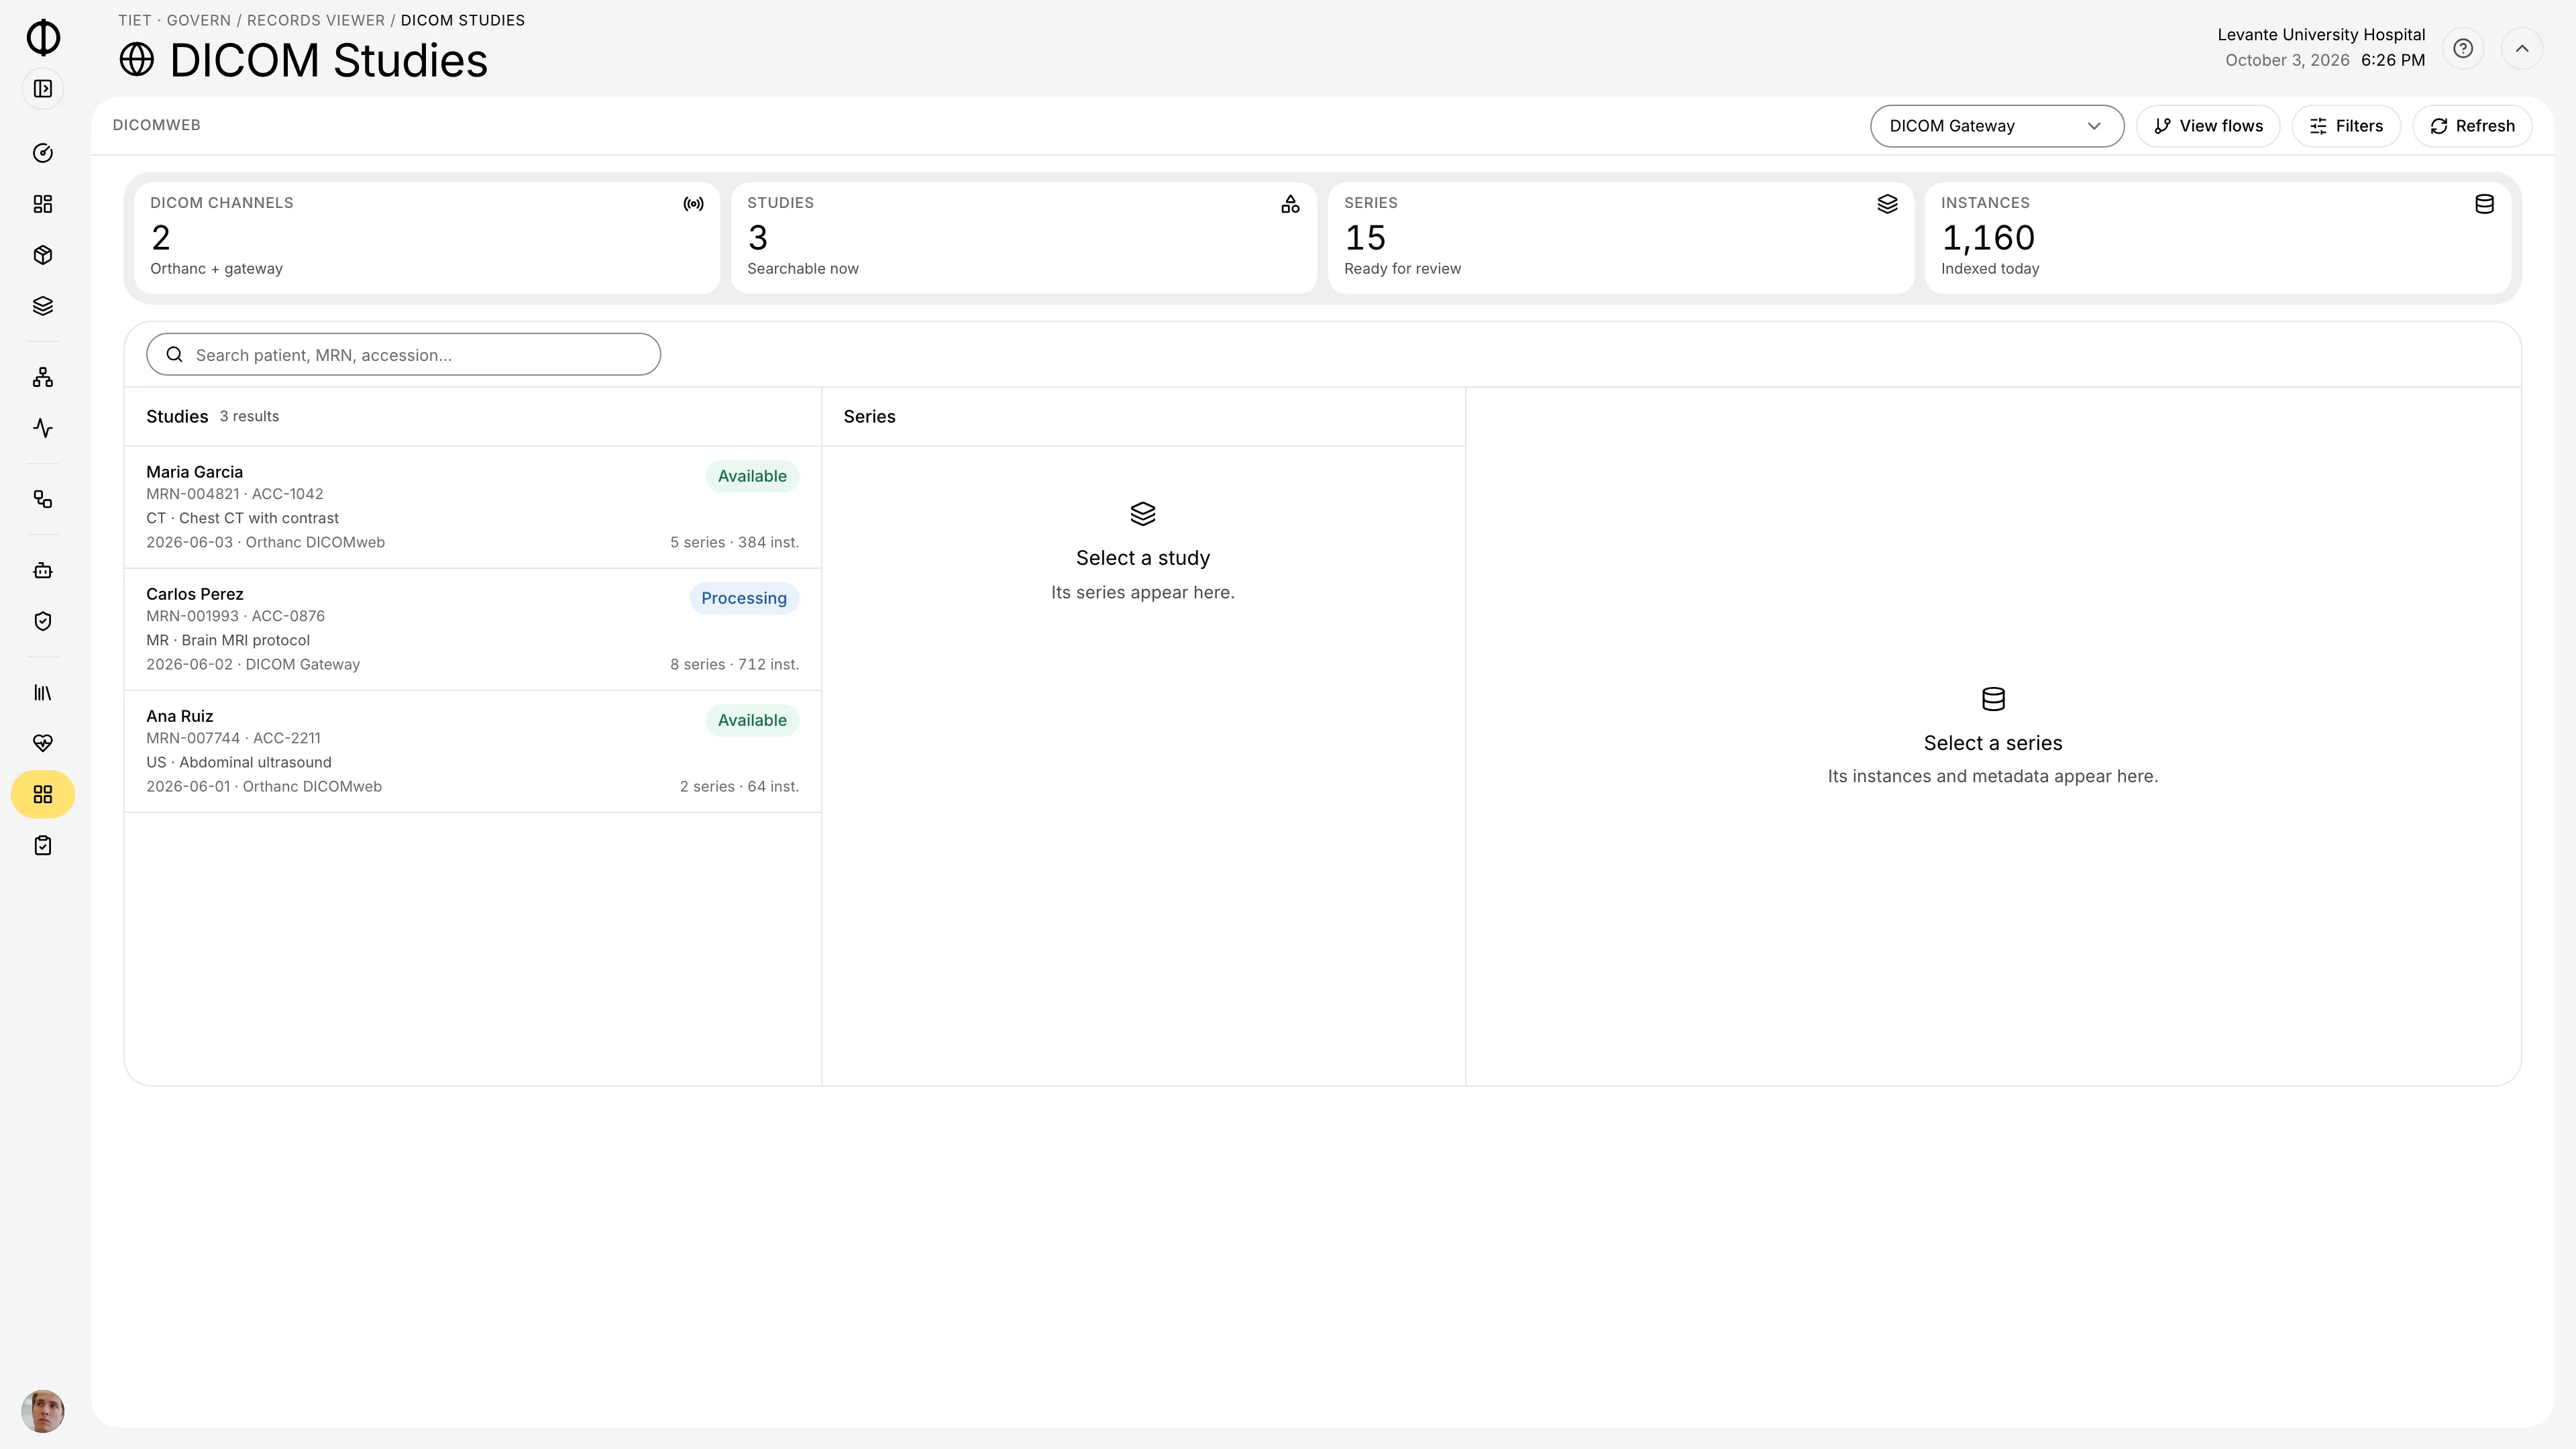
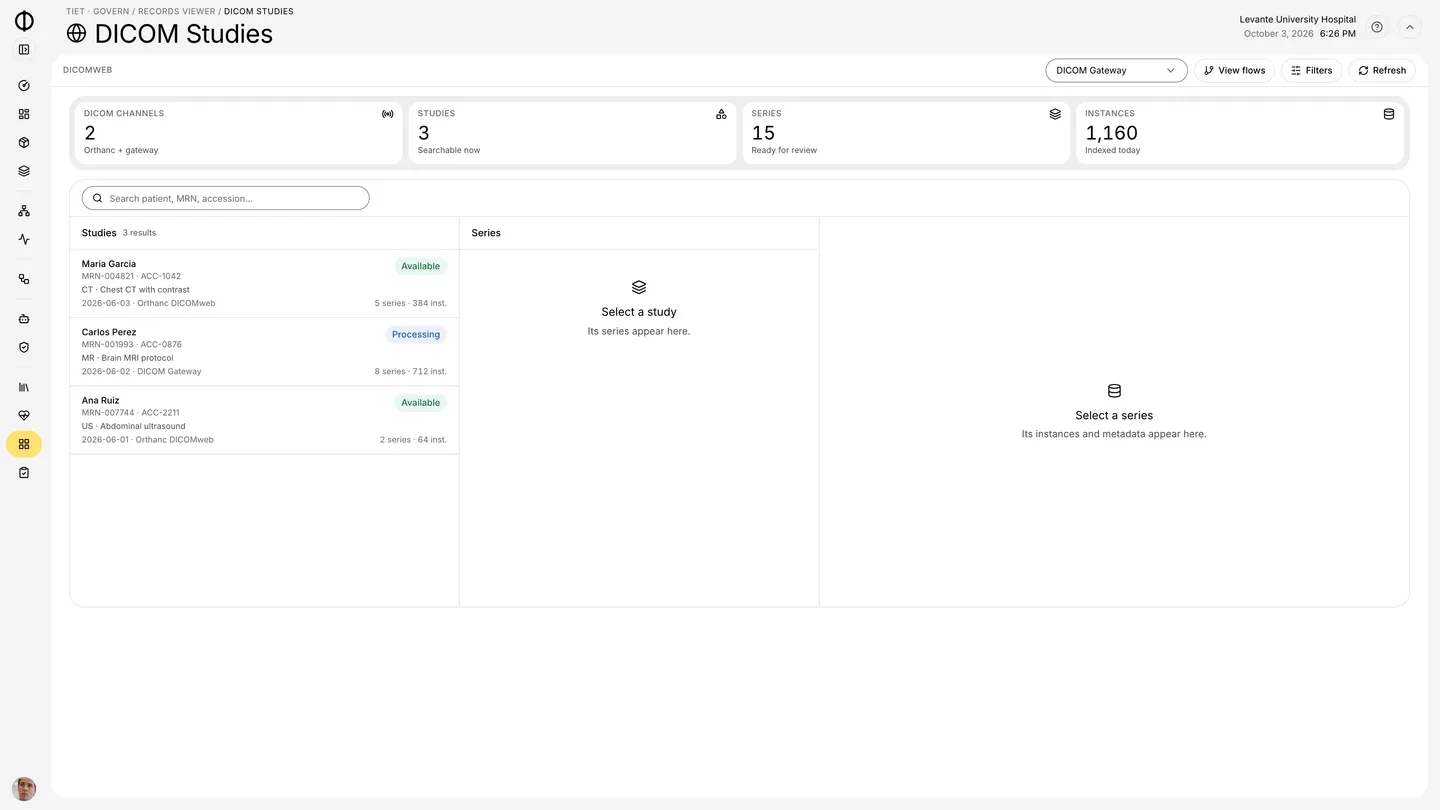
Para responder con honestidad necesitas cuatro tipos de datos que normalmente viven cuatro vidas distintas: la imagen de TC, la historia clínica estructurada, el panel genómico y los resultados. En Tietai entran en una sola sesión como fuentes conectadas: una base de datos clínica OMOP de un par de miles de pacientes, un PACS que extrae estudios de TC abdominal por DICOM, un panel VCF de unos cientos de muestras y una exportación de la historia clínica con los informes de alta. Nada ha salido todavía de su sistema de origen. Simplemente están a la vista, juntos, por primera vez.
Y enseguida aparece el primer problema del mundo real, el que conoce todo equipo de investigación y que toda demo ignora: una de esas fuentes está llena de datos de pacientes identificados. Los informes de alta tienen nombres, números de historia, fechas, de todo. Este es justo el punto donde muere gran parte de la velocidad de la investigación, en la carrera improvisada, nerviosa y auditada a mano por eliminar la PHI antes de que nadie pueda tocarla.
La desidentificación como primer paso, no como algo posterior
Así que ahí es donde el entorno empieza a trabajar. La exportación identificada de la historia clínica muestra un aviso que no desaparece hasta que se resuelve, y la desidentificación se ejecuta como una operación de primer nivel en el lienzo: un pipeline de desidentificación versionado que elimina la PHI, etiqueta las entidades que ha encontrado (identificadores de paciente, diagnósticos, medicación) y produce un bloque derivado limpio. Ese bloque está firmado: lleva la identidad del pipeline, una versión y la firma de un clínico que certifica que el paso se realizó y superó la revisión.
Este es el primer punto donde el calendario se desploma, y merece la pena ser precisos sobre por qué. No es que una máquina haya desidentificado texto; muchas herramientas lo hacen. Es que la desidentificación es ahora un paso del registro del estudio y no algo que alguien hizo el martes pasado en un script que nadie guardó. La procedencia de “cómo sabemos que esto es seguro de usar” viaja con los datos desde el primer movimiento. Nadie tiene que reconstruirla después, porque nunca estuvo separada de los datos.
A partir de ahí toma forma la cohorte limpia y estructurada: unos cientos de pacientes con adenocarcinoma ductal en estadio II o superior, seudonimizados, firmados, construidos una vez y reutilizados en todo lo que viene después. Define la cohorte una sola vez y cada paso posterior —la lectura de imagen, la curva de supervivencia, el panel de variantes— apunta a la misma definición. La versión del despilfarro investigador en la que tres análisis usaron en silencio tres cohortes ligeramente distintas simplemente no puede ocurrir, porque solo hay una cohorte y todo está conectado a ella.
Donde los agentes hacen la lectura
Ahora, el problema del volumen. Unos cientos de pacientes significan decenas de estudios de TC, con cientos de cortes cada uno, que alguien tiene que leer y medir. Es el tipo de trabajo que se come el mes de un residente investigador.
En el entorno, un agente lector de radiología hace la primera pasada por todo el lote. Carga cada serie, segmenta y mide, contrasta con los criterios de inclusión de la cohorte y redacta hallazgos estructurados (una masa hipodensa en la cabeza del páncreas, una medida de dilatación del conducto, un posible contacto vascular), cada uno etiquetado con una puntuación de confianza. No decide nada por su cuenta en silencio. Cuando llega a un estudio donde la lectura importa de verdad y la confianza es solo intermedia (un posible contacto con la arteria mesentérica superior justo en el umbral en que el propio protocolo de imagen debería cambiar), se detiene y pregunta. El hallazgo se muestra a un clínico firmante con la decisión concreta explicada, y el lote espera una respuesta humana antes de continuar.
Esa pausa es todo el diseño en miniatura. El agente comprime la parte tediosa y de alto volumen de semanas a una tarde. La persona dedica su escasa atención solo al puñado de decisiones que de verdad necesitan criterio. Velocidad y rigor dejan de ser un compromiso, porque el agente no sustituye la decisión del clínico; le quita todo lo que la rodea excepto la decisión misma.
El mismo patrón funciona en paralelo para la genómica. Un anotador genómico reduce el VCF al panel que importa (variantes patogénicas por encima de un umbral de frecuencia alélica), y ese panel anotado queda como una entrada bloqueada y pendiente de firma: no puede alimentar en silencio un resultado posterior hasta que una persona lo haya revisado y firmado. La anotación es rápida; la responsabilidad es explícita.
El hallazgo, y por qué puedes confiar en él
Con una cohorte limpia, un conjunto de imágenes leídas y un panel de variantes firmado, el análisis de resultados es casi un anticlímax, y de eso se trata. Una comparación de supervivencia de Kaplan-Meier según el estado de resección sale de datos ya conectados y ya fiables: un hazard ratio de 0,68, una p de log-rank de 0,004 y una mediana de supervivencia global de 14,2 meses frente a 9,1, con 187 eventos en la cohorte. Una señal real, obtenida no tras un trimestre de manipular datos, sino como el siguiente clic natural una vez que esa manipulación se eliminó por diseño.
Y después, la última milla que la investigación suele tratar como un proyecto aparte: poner el hallazgo en contexto. Un agente de revisión de la evidencia elabora un informe frente a la literatura externa (los resultados de PREOPANC-2, un metaanálisis de 2024, la guía actual de la ESMO) y califica la solidez de cada fuente al estilo GRADE, para que la señal interna se lea junto a lo que el campo ya sabe. El informe está firmado, anonimizado y se sitúa en el mismo lienzo que las imágenes de las que salió.
Esto es lo que hace que la cadena completa valga más que la suma de sus pasos. Cada bloque lleva su linaje. El informe de evidencia remite al análisis de supervivencia, que remite a la cohorte, que remite a la exportación desidentificada y a las series de TC, que remiten, a través del agente lector, a la extracción bruta del PACS. Haz clic en cualquier resultado y puedes recorrer hacia atrás la fuente exacta en la que se apoya, la versión de la herramienta que lo produjo y el clínico que lo firmó. El hallazgo no es una cifra en una presentación que alguien te pedirá justificar de nuevo dentro de seis meses. Es una afirmación con toda su cadena de custodia adjunta.
Eso no es documentación que escribes después. Es una propiedad del sistema. Lo que significa que las dos cosas que una organización de investigación necesita de verdad de un resultado rápido (¿podemos reproducirlo? ¿podemos defenderlo?) quedan respondidas por construcción, no por arqueología.
Por qué esto es lo que acelera a un equipo
Si te alejas del hilo, la aceleración no viene de ningún componente ingenioso aislado. Viene de eliminar los huecos que antes había entre los componentes.
El equipo nunca vuelve a integrar datos entre pasos, porque los pasos comparten una columna vertebral. Nunca vuelve a establecer la confianza en un resultado, porque la confianza viaja con él como firmas y linaje. Nunca repite la desidentificación ni vuelve a derivar una cohorte, porque ambas son objetos versionados de primer nivel, construidos una vez. Solo dedica criterio humano donde hace falta criterio, porque los agentes absorben el volumen y devuelven las decisiones. Y cuando un estudio abarca más de un hospital, las mismas garantías se mantienen entre centros: con la malla de Tiet · Connect, cada paso se ejecuta donde está permitido y solo cruzan una frontera resultados desidentificados y derivados, de modo que una red de investigación puede compartir el hallazgo sin que ningún centro comparta una historia de paciente.
Nada de esto sustituye al investigador. Una persona define la pregunta, responde a las consultas que escalan los agentes y firma los resultados. El entorno incluso muestra cuándo dos editores están a la vez en las notas de criterios de inclusión, porque la investigación es un deporte de equipo y el registro debe reflejarlo. Lo que cambia es adónde va el tiempo del investigador. Menos a la fontanería, las exportaciones, volver a teclear y reconstruir la procedencia. Más a la ciencia de verdad.
El sector pasó años dando a los equipos de investigación mejores herramientas (un visor mejor, un paquete estadístico mejor, un modelo de anotación mejor) y luego los dejó cargando a mano los datos entre los huecos de esas herramientas. Los huecos siempre fueron donde se iba el tiempo. Un sistema integrado no hace que ningún paso concreto sea radicalmente más rápido. Hace que desaparezcan los traspasos. Y cuando desaparecen los traspasos, una pregunta que antes llevaba un trimestre puede responderse, con toda su procedencia intacta, en cuestión de días.
Ese es el entorno de investigación en el que Tietai se está construyendo para convertirse: no una herramienta más rápida en el montón, sino el lienzo que convertirá el montón en un único sistema, con la ciencia en manos humanas y la maquinaria honesta.
Roberto Cruz
CEO, Tietai — The Healthcare Execution Platform.
Tráenos tu peor problema de datos o de integración y definiremos un Proof of Value a su medida. contact@tiet.ai